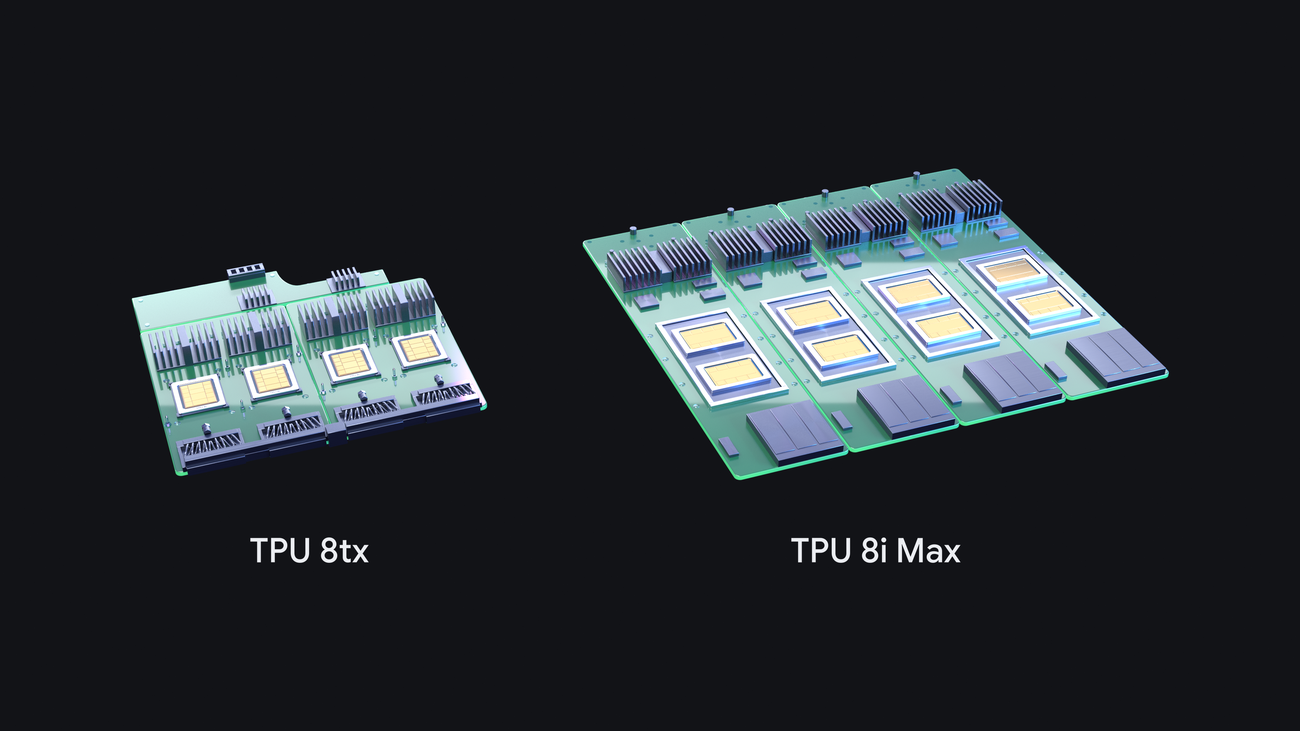
Google nambah dua anggota baru di keluarga chip AI mereka. Lewat blog resminya, Senin (9/11), perusahaan mengumumkan TPU 8tx dan TPU 8i Max sebagai bagian dari portofolio TPU generasi kedelapan. Ini kali pertama Google meluncurkan empat sistem TPU dalam satu tahun.
Dua nama itu bukan sekadar varian kosmetik. TPU 8tx diposisikan buat inferensi yang butuh keamanan tingkat hardware, sementara TPU 8i Max didesain buat menangani context window raksasa. Keduanya melengkapi TPU 8t yang fokus ke training skala besar dan TPU 8i sebagai mesin reasoning.
Yang menarik, alasan Google bikin dua sistem tambahan ini cukup membumi: pelanggan mereka mulai berubah dari manusia jadi agen AI.
Apa bedanya chip baru dan sistem baru
Di pengumuman itu Google sempat menjelaskan perbedaan yang sering dianggap sama. Merancang chip baru artinya menyusun miliaran transistor di wafer silikon, proses bertahun-tahun yang dibatasi hukum fisika dan siklus manufaktur panjang. Sementara sistem adalah soal bagaimana compute, networking, dan storage dirakit mengelilingi chip tersebut.
Google memilih jalur kedua untuk dua produk ini. Mereka tidak menunggu chip anyar keluar dari fab, tapi mengubah konfigurasi sistem supaya kebutuhan pelanggan bisa dilayani lebih cepat. Praktis, tapi juga tanda bahwa permintaan pasar sekarang bergerak lebih cepat dari siklus pembuatan silikon.
Alasannya jelas. Komputasi AI sudah bergeser dari skala manusia ke skala agen. Bisnis minta akselerator yang bisa bernalar di atas context window jutaan token, dan sebagian pelanggan di sektor teregulasi butuh enkripsi khusus untuk workload tertentu.
TPU 8tx: inferensi yang tidak boleh bocor
TPU 8tx dirancang untuk secure dan confidential inference. Artinya data yang sedang diproses tetap terlindungi di level hardware, bukan cuma dienkripsi saat disimpan atau dikirim. Untuk bank, rumah sakit, atau instansi pemerintah, poin ini sering jadi penghalang utama sebelum mereka mau menaruh workload AI di cloud.
Selama ini confidential computing di dunia GPU lebih banyak mengandalkan enkripsi di memori dan isolasi virtual machine. Pendekatan di level chip memberi jaminan lebih kuat, karena proteksinya tidak bergantung pada lapisan software yang bisa salah konfigurasi.
Google tidak merinci berapa penalti performa dari fitur keamanan ini, dan itu wajar. Pertanyaan yang lebih relevan: apakah biaya tambahannya masuk akal dibanding memisahkan workload sensitif ke infrastruktur on-premise.
TPU 8i Max dan tembok memori
TPU 8i Max menyasar masalah yang mulai terasa di banyak proyek agen AI, yaitu memori. Model sekarang diminta membaca dokumen panjang, riwayat percakapan, dan hasil tool call sekaligus. Semua itu menumpuk di KV cache dan bikin chip menunggu data, bukan menghitung.
Google mengklaim TPU 8i Max punya kepadatan komputasi per rack tertinggi di jajaran mereka. Bersama TPU 8i, sistem ini dirancang untuk menembus batas yang mereka sebut memory wall, dengan memangkas latensi antar-chip.
Untuk konteks, TPU 8t dan 8i yang sudah lebih dulu hadir memberi peningkatan hingga 2,7 kali performa training dan 80 persen price-performance inferensi lebih baik dibanding generasi sebelumnya. Angka itu klaim internal Google, jadi tetap perlu diuji pihak ketiga sebelum dijadikan patokan.
Baca juga: Krisis Listrik Data Center AI, Mesin Jet Bekas Boeing 747 Jadi Pembangkit
Software yang bikin TPU lebih gampang dipakai
Bagian ini sering luput dari sorotan, padahal dampaknya paling langsung terasa buat developer. Google memperluas dukungan PyTorch dan merilis vLLM-TorchTPU sebagai stack serving native. Di benchmark yang menguji agentic coding dan pekerjaan konteks panjang, stack itu mencatat price-performance terbaik menurut Google.
Yang juga menarik: TPU Sync. Ini lapisan model-state yang akan dibuka sebagai open source. Fungsinya menyatukan HBM di chip, DRAM host, storage bersama, dan jaringan data center jadi satu hierarki memori. KV cache besar bisa dipindah keluar chip dalam hitungan milidetik, sementara sinkronisasi bobot RL memangkas latensi transfer dan Time to First Token lebih dari 90 persen.
Ada juga Cloud Pathways yang membawa runtime Google DeepMind ke semua pelanggan Google Cloud. Dengan arsitektur single-controller, beberapa slice TPU bisa diatur seolah satu mesin lokal. Untuk pekerjaan yang berjalan berhari-hari, fitur ini menjaga job tetap jalan saat ada gangguan hardware.
Hampir 100 pelanggan, dan TPU mulai pindah rumah
Google menyebut bisnis TPU mereka kini punya hampir 100 pelanggan, dari laboratorium riset frontier, perusahaan trading, retailer, sampai universitas. Yang paling berubah dibanding beberapa tahun lalu: pelanggan sekarang boleh menaruh TPU langsung di data center mereka sendiri.
Langkah ini mengubah posisi TPU. Kalau dulu chip ini cuma bisa diakses lewat Google Cloud, sekarang dia ikut bersaing di meja pengadaan infrastruktur on-premise. Buat perusahaan yang terikat aturan data lokal, opsi ini menghapus salah satu alasan utama menolak TPU.
Baca juga: Merdeka AI Lintasarta: Infrastruktur AI yang Datanya Tetap di Indonesia
Kenapa ini relevan buat developer Indonesia
Dua hal yang paling berdampak ke sini adalah dukungan PyTorch dan rencana open source TPU Sync. Banyak tim di Indonesia sudah punya kode training berbasis PyTorch. Kalau porting ke TPU tidak lagi butuh menulis ulang model, biaya pindah platform turun drastis.
Fitur suspend otomatis untuk sesi agen juga terdengar sepele tapi penting. Agen AI itu stateful. Mereka sering berhenti beberapa detik sampai berjam-jam menunggu database, tool eksternal, atau balasan manusia. Kalau compute tetap menyala selama menunggu, tagihan membengkak tanpa hasil. Google bilang software baru mereka menangguhkan sesi idle dan melanjutkannya lagi, yang langsung memotong biaya infrastruktur.
Soal confidential inference, ini justru bisa jadi alasan buat sektor yang selama ini ragu. Perbankan dan layanan kesehatan di Indonesia menghadapi aturan perlindungan data pribadi yang cukup ketat. Kalau proteksi data bisa dijamin di level chip, adopsi AI di sektor itu punya jalan lebih mulus.
Bukan cuma soal Google lawan Nvidia
Bloomberg membingkai pengumuman ini sebagai eskalasi persaingan Google dengan Nvidia lewat versi chip yang makin terspesialisasi. Reuters menyorot sisi lain, yaitu permintaan cloud yang sedang melonjak dan jadi pemicu utama.
Dua sudut pandang itu sama-sama masuk akal. Nvidia masih memegang mayoritas pasar akselerator AI, terutama karena ekosistem CUDA yang sudah matang belasan tahun. Tapi pelanggan besar mulai jengah dengan harga dan ketersediaan GPU. Setiap kali Google membuktikan TPU bisa menangani model frontier dengan biaya lebih rendah, posisi tawar pembeli membaik.
Yang perlu dicatat, TPU bukan produk rakitan yang bisa dibeli siapa saja lalu dipasang di server sendiri seperti GPU. Aksesnya masih lewat Google Cloud atau lewat kesepakatan khusus untuk deployment di data center pelanggan. Jadi cerita “Nvidia akan tergeser” terlalu dini. Yang lebih akurat: pilihan mulai bertambah, dan itu sehat.
Apa yang belum jelas
Google belum membeberkan harga, kapasitas HBM, atau ketersediaan regional untuk TPU 8tx dan 8i Max. Semua angka performa yang beredar berasal dari pengukuran internal mereka sendiri, termasuk klaim price-performance di benchmark agentic coding.
Ada satu hal lagi yang layak ditunggu: seberapa cepat TPU Sync benar-benar rilis sebagai open source. Rencana open source sering melunak jadi “tersedia untuk mitra terpilih” begitu masuk tahap produksi.
Buat yang sekarang sedang membangun produk berbasis agen, pengumuman ini lebih tepat dibaca sebagai sinyal. Biaya inferensi konteks panjang kemungkinan besar akan terus turun dalam 12 bulan ke depan, dan keputusan arsitektur hari ini sebaiknya tidak mengunci diri ke satu vendor saja.
Sumber
- Google Blog: Our newest TPUs: 8tx and 8i Max, built for the agentic era
- Reuters: Google unveils new AI chip variants as cloud demand surges
- Bloomberg: Google Escalates Nvidia Rivalry With Specialized Versions of AI Chips
- The Next Web: Google unveils TPU 8tx and 8i Max chips for secure and long-context AI
Sumber gambar: Google Blog
